
計畫名稱
結合反思學習與幻覺解析以精進大型語言模型創造力之研究
計畫目標
本計畫旨在解決大型語言模型於醫療領域應用時,面臨之「可信度不足」與「缺乏可解釋性」兩大瓶頸。目標為打造一套具備元認知(Meta-cognition)之自主修正代理人系統,透過導入創新的「反思學習」與「決策監督」機制,賦予模型自我檢視與修正錯誤的能力。 具體而言,本計畫將建構「認知錯誤地圖」以精確解析並標記生成內容中的幻覺與偏誤,並研發兼具公平性與反思機制的基礎模型代理系統。期能推動 AI 從單純的語言模仿,進化為具備高正確性、高解釋性及高問責性的智慧體,實現「可信賴且能自我精進」之醫療輔助決策目標。
計畫概述
大型語言模型 (LLMs) 雖具潛力,但在醫療等專業場域應用時,面臨「可信度不足」與「缺乏可解釋性」兩大瓶頸,常因無法自我檢視而產生「幻覺」,成為臨床輔助的最大信任危機。本計畫旨在突破此困境,將 AI 轉化為具備「元認知」與「自主修正能力」的可信賴智慧體。
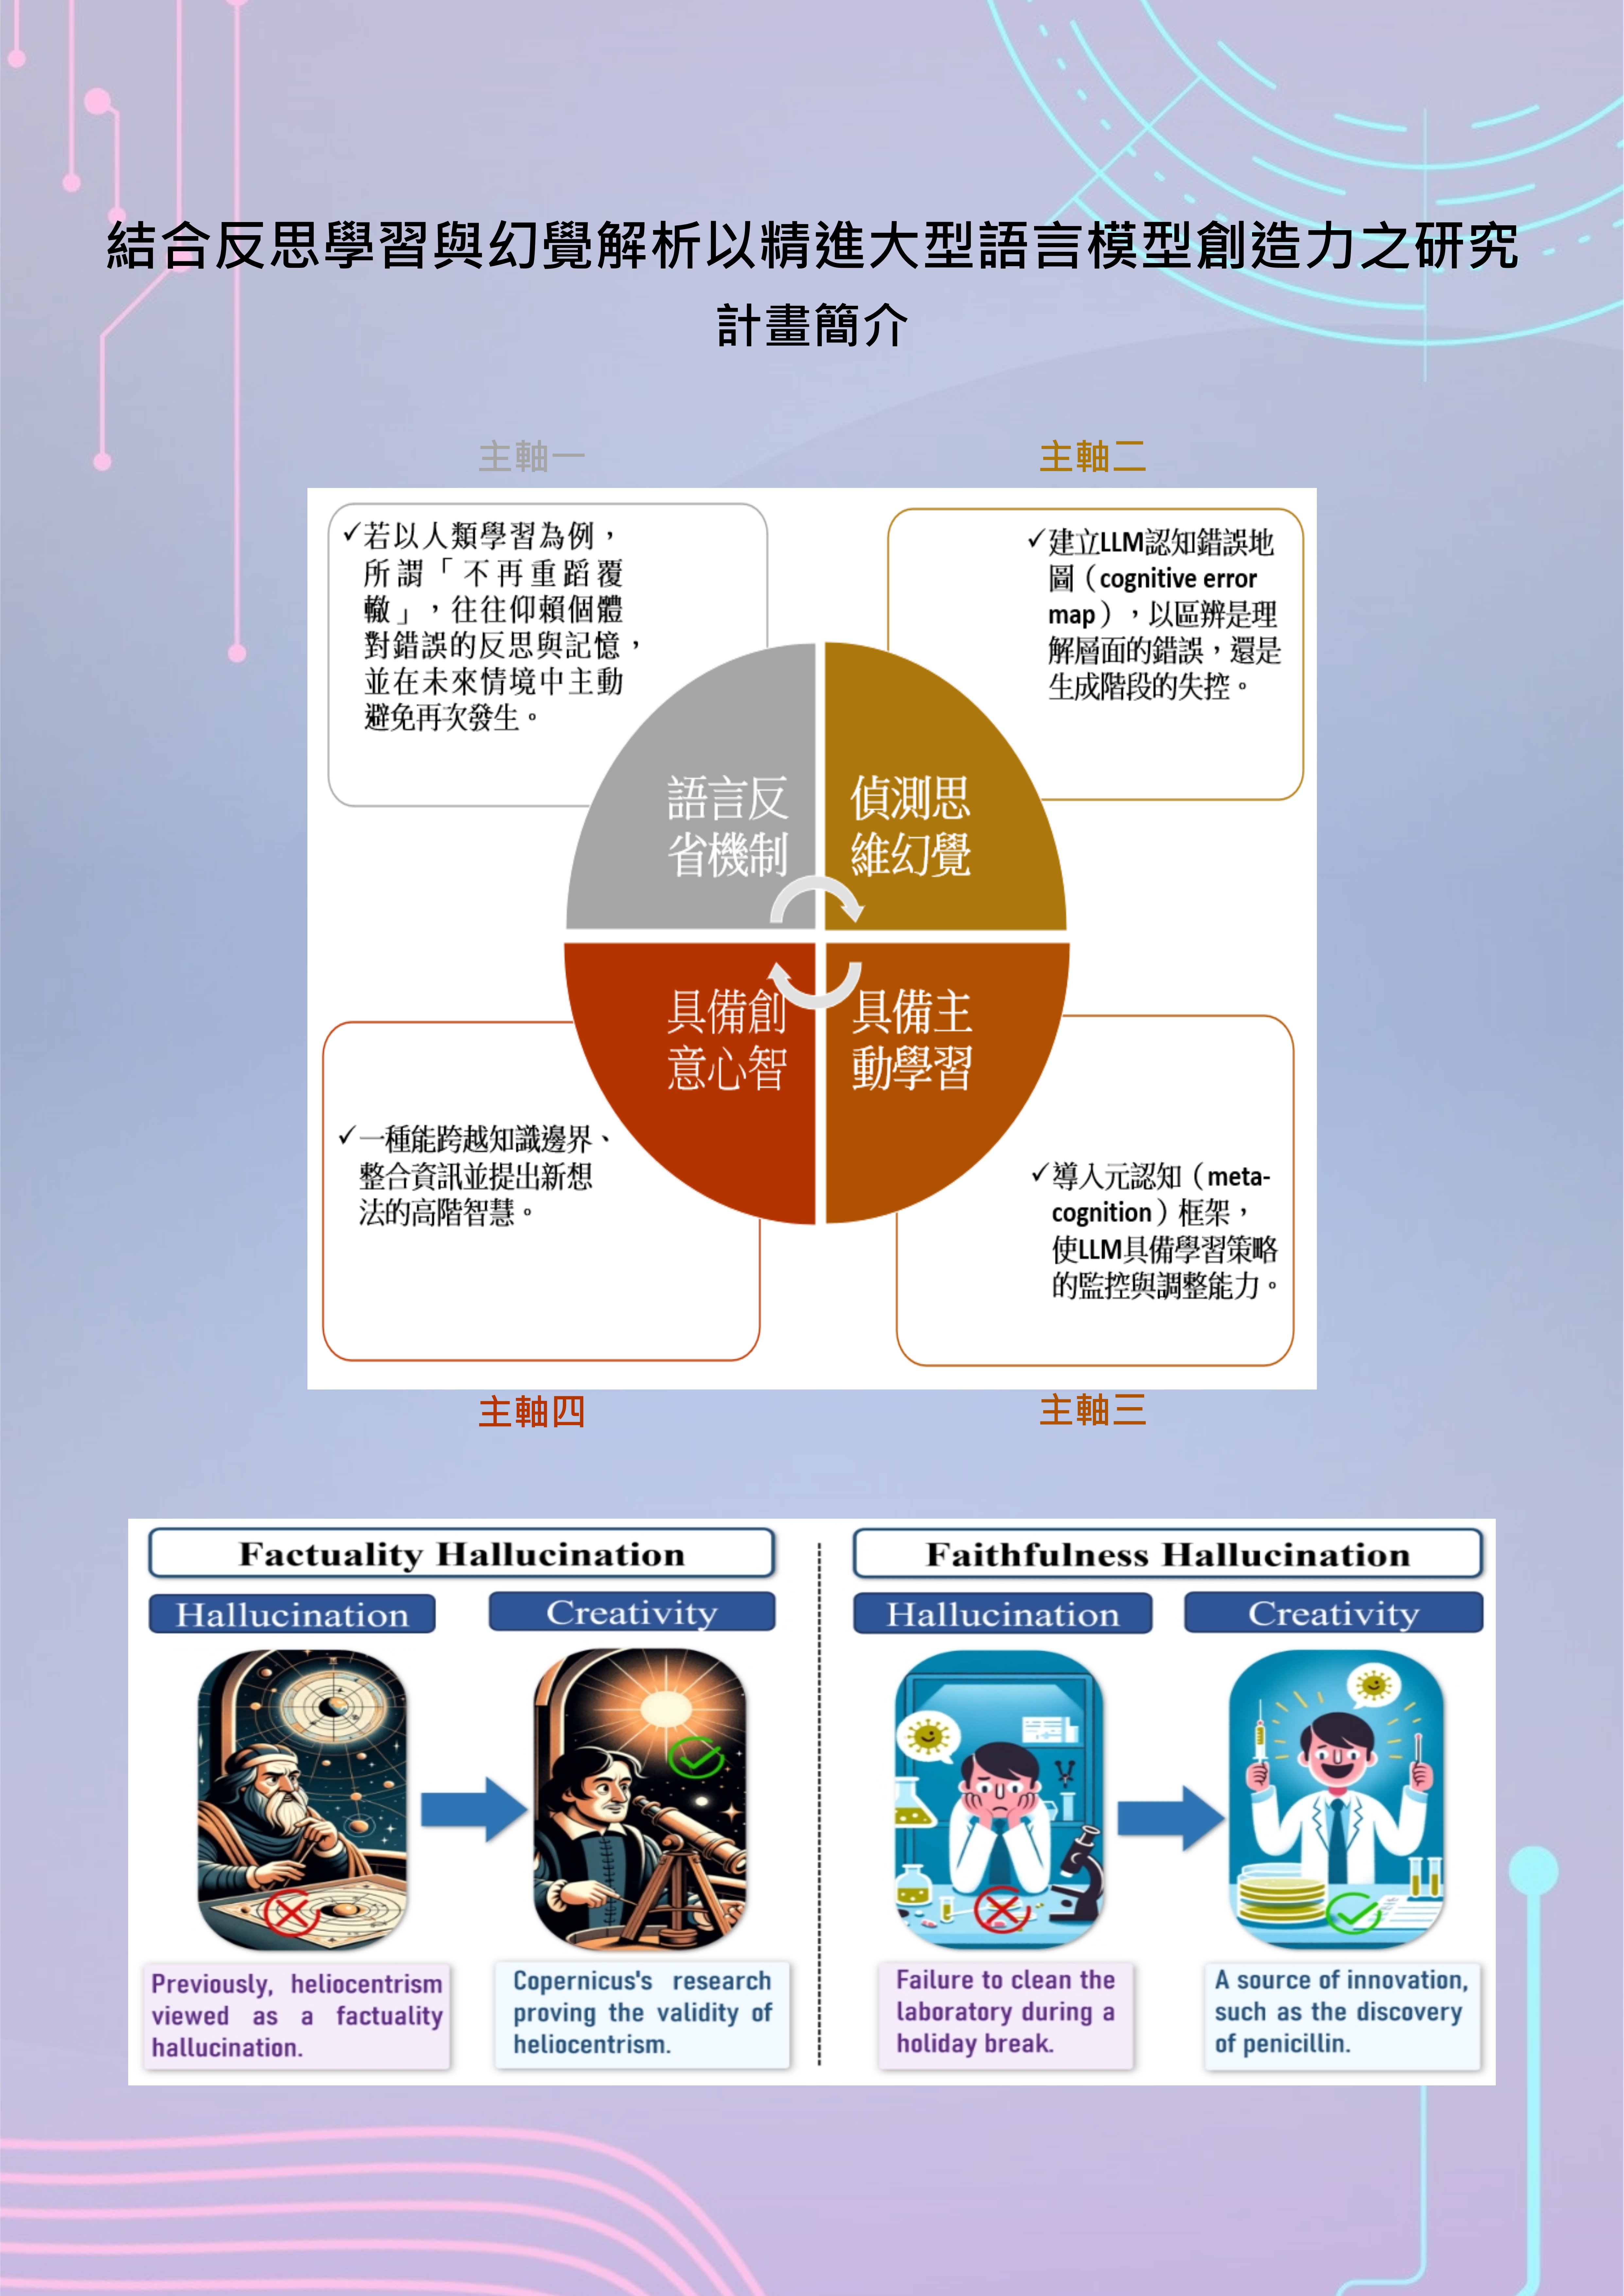
為此,本計畫提出四大創新研究主軸:首先,我們將建立「語言反省機制」,突破模型僅依賴人類回饋 (RLHF) 的淺層校正,賦予模型反省性記憶以避免重蹈覆轍,而非僅是表層的措辭修正。 其次,建構「認知錯誤地圖」,結合內部表徵分析與輸出模式比對,精確區辨幻覺是源於知識空缺、邏輯斷裂或生成失控,從而對症下藥進行干預。
再者,為突破模型被動更新知識的限制,我們將導入「元認知框架」打造主動學習語言智慧體,使模型能主動察覺知識缺口並從互動中汲取新知,實現可持續的自我進化。 最後,本計畫視「創造力」為高階智慧的綜合指標,透過建構聯想力思維架構,訓練模型進行跨邊界的知識整合與假說推導,使其成為能協助人類進行科學創新與邏輯推理的思維夥伴。
透過整合此四大主軸,本計畫期望建立一套具備高問責性與正確性的 AI 代理系統,為醫療診斷與科學研究提供安全、可解釋且具創造力的智慧輔助基石。